
Die entscheidende Frage ist nicht, ob Cloud-Spracherkennung „schnell“ ist. Sie lautet, wohin die Zeit geht, nachdem du aufgehört hast zu sprechen. Ein lokaler Workflow kann Upload-Verzögerung und Server-Round-Trips beseitigen. Ein Cloud-Workflow kann das nicht.
Bereinigung mit eigenem Schlüssel
60ms RTT · 5 Mbit/s Upload
Cloud-Diktat
Audio hochladen → Cloud-STT
Voice Type
Lokale STT → LLM-Überarbeitung
Das Audio bleibt auf deinem Mac. Nur Text geht an dein LLM.
Voice Type ist 11s schneller (80% weniger Wartezeit)
Details zur Berechnung
• Cloud-Audio: 128 kbps, STT ~50× Echtzeit
• Auf dem Gerät: ~1,2 s Abschluss auf dem M1 Pro
• LLM: Cerebras ~1000 Tokens/Sek.
• Sprechen: ~225 wpm (schnelle Sprecher)
So liest du die Demo
- Der Cloud-Weg umfasst Netzwerk-Handshake, Upload-Zeit, Erkennungszeit und Overhead des Dienstes.
- Der lokale Weg hält die Spracherkennung auf dem Gerät und braucht nur dann zusätzliche Zeit, wenn du eine externe Überarbeitung des Texts anforderst.
- Es geht nicht darum, eine magische Zahl zu liefern. Die Demo zeigt, welche Teile des Wegs wegfallen, wenn das Audio den Rechner nicht verlassen muss.
Was das Modell annimmt
Die interaktive Demo arbeitet mit einfachen, ausdrücklichen Annahmen: Netzwerk-Round-Trip-Zeit, Upload-Bandbreite, eine grobe Transkriptionsgeschwindigkeit in der Cloud und ein lokaler Abschlussschritt für das letzte Stück Sprache. Das macht sie ehrlich. Echte Anbieter unterscheiden sich, aber die Struktur der Verzögerung bleibt gleich.
Das entspricht der üblichen Dokumentation von Streaming-Spracherkennung: Das Audio wird in Blöcke zerlegt, über einen Live-Stream gesendet, schrittweise verarbeitet und nach dem Ende der Sprache abgeschlossen. Größere Netzwerkverzögerungen und langsamere Uploads müssen trotzdem irgendwo bezahlt werden.
Warum das im Alltag zählt
- Für eine einzeilige Notiz auf schnellem Glasfaser kann sich die Cloud-Latenz akzeptabel anfühlen.
- Bei wiederholten kurzen Diktaten im normalen Arbeitsalltag summiert sich jede zusätzliche Sekunde zu Reibung.
- Bei schlechtem Hotel-WLAN, im Zug oder ohne Verbindung geht es nicht mehr um Geschwindigkeit, sondern darum, ob der Workflow überhaupt funktioniert.
Was der lokale Weg in der Praxis misst
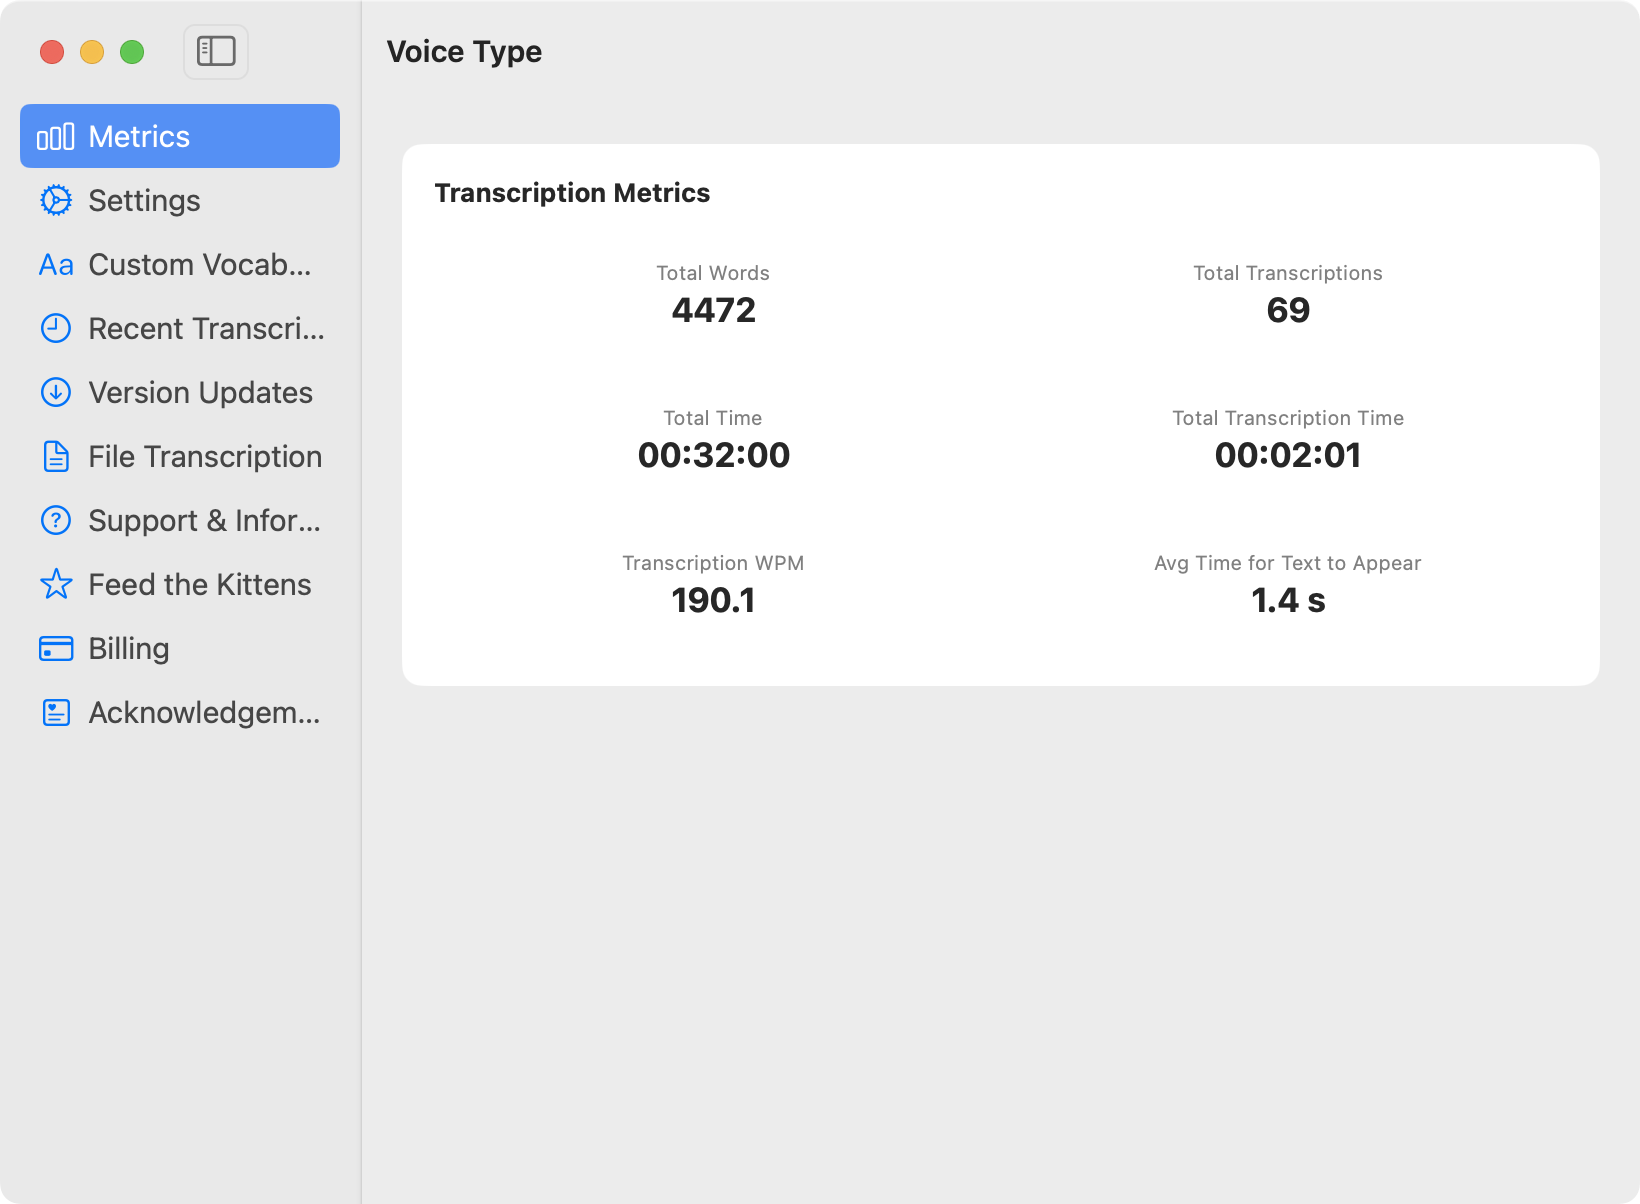
Die Demo oben ist ein Modell. Die App führt außerdem eigene Zähler, sodass die lokale Hälfte des Modells eine echte Zahl neben sich hat. Die Sitzung unten kam bei 69 Transkriptionen auf durchschnittlich 1,4 Sekunden vom Ende der Sprache bis zum Text auf dem Bildschirm, ohne Upload und ohne Round-Trip auf diesem Weg.
Quellen
Voice Type hält den Audioweg lokal. Optionale Überarbeitungen können weiterhin dein eigenes LLM nutzen, aber der Schritt der Spracherkennung muss nicht auf das Netzwerk warten.
Die kostenlose 7-Tage-Testphase ausprobieren