
La pregunta útil no es si el reconocimiento de voz en la nube es «rápido». Es adónde se va el tiempo después de que dejas de hablar. Un flujo local puede eliminar el retraso de subida y los viajes de ida y vuelta al servidor. Un flujo en la nube no puede.
Limpieza con tu propia clave
60ms de RTT · 5 Mbps de subida
Dictado en la nube
Subir audio → STT en la nube
Voice Type
STT local → reescritura con LLM
El audio se queda en tu Mac. Solo el texto llega a tu LLM.
Voice Type es 11s más rápido (80% menos de espera)
Detalles del cálculo
• Audio en la nube: 128 kbps, STT ~50× tiempo real
• En el dispositivo: ~1,2 s para finalizar en un M1 Pro
• LLM: Cerebras ~1000 tokens/s
• Habla: ~225 wpm (hablante rápido)
Cómo leer la demo
- La ruta en la nube incluye el handshake de red, el tiempo de subida, el tiempo de reconocimiento y la sobrecarga del servicio.
- La ruta local mantiene el reconocimiento de voz en el dispositivo y solo suma tiempo extra opcional si pides una reescritura externa del texto.
- El objetivo no es sacar un número mágico. Es mostrar qué partes de la ruta desaparecen cuando el audio no tiene que salir del equipo.
Qué supone el modelo
La demo interactiva usa supuestos simples y explícitos: el tiempo de ida y vuelta de la red, el ancho de banda de subida, una velocidad aproximada de transcripción en la nube y un paso de finalización local para el último fragmento de voz. Eso la hace honesta. Los proveedores reales difieren, pero la estructura del retraso es la misma.
Esto refleja cómo suelen documentarse los sistemas de voz en streaming: el audio se divide en fragmentos, se envía por una transmisión en vivo, se procesa de forma incremental y se finaliza cuando termina el habla. Los retrasos de red mayores y las subidas más lentas siguen teniendo que pagarse en algún punto.
Por qué importa en el uso real
- Para una nota de una línea con fibra rápida, la latencia de la nube puede parecer aceptable.
- Con ráfagas cortas y repetidas de dictado durante el trabajo normal, cada segundo extra se acumula como fricción.
- Con un mal Wi-Fi de hotel, en el tren o sin conexión, la diferencia deja de ser de velocidad y pasa a ser si el flujo funciona o no.
Lo que mide la ruta local en la práctica
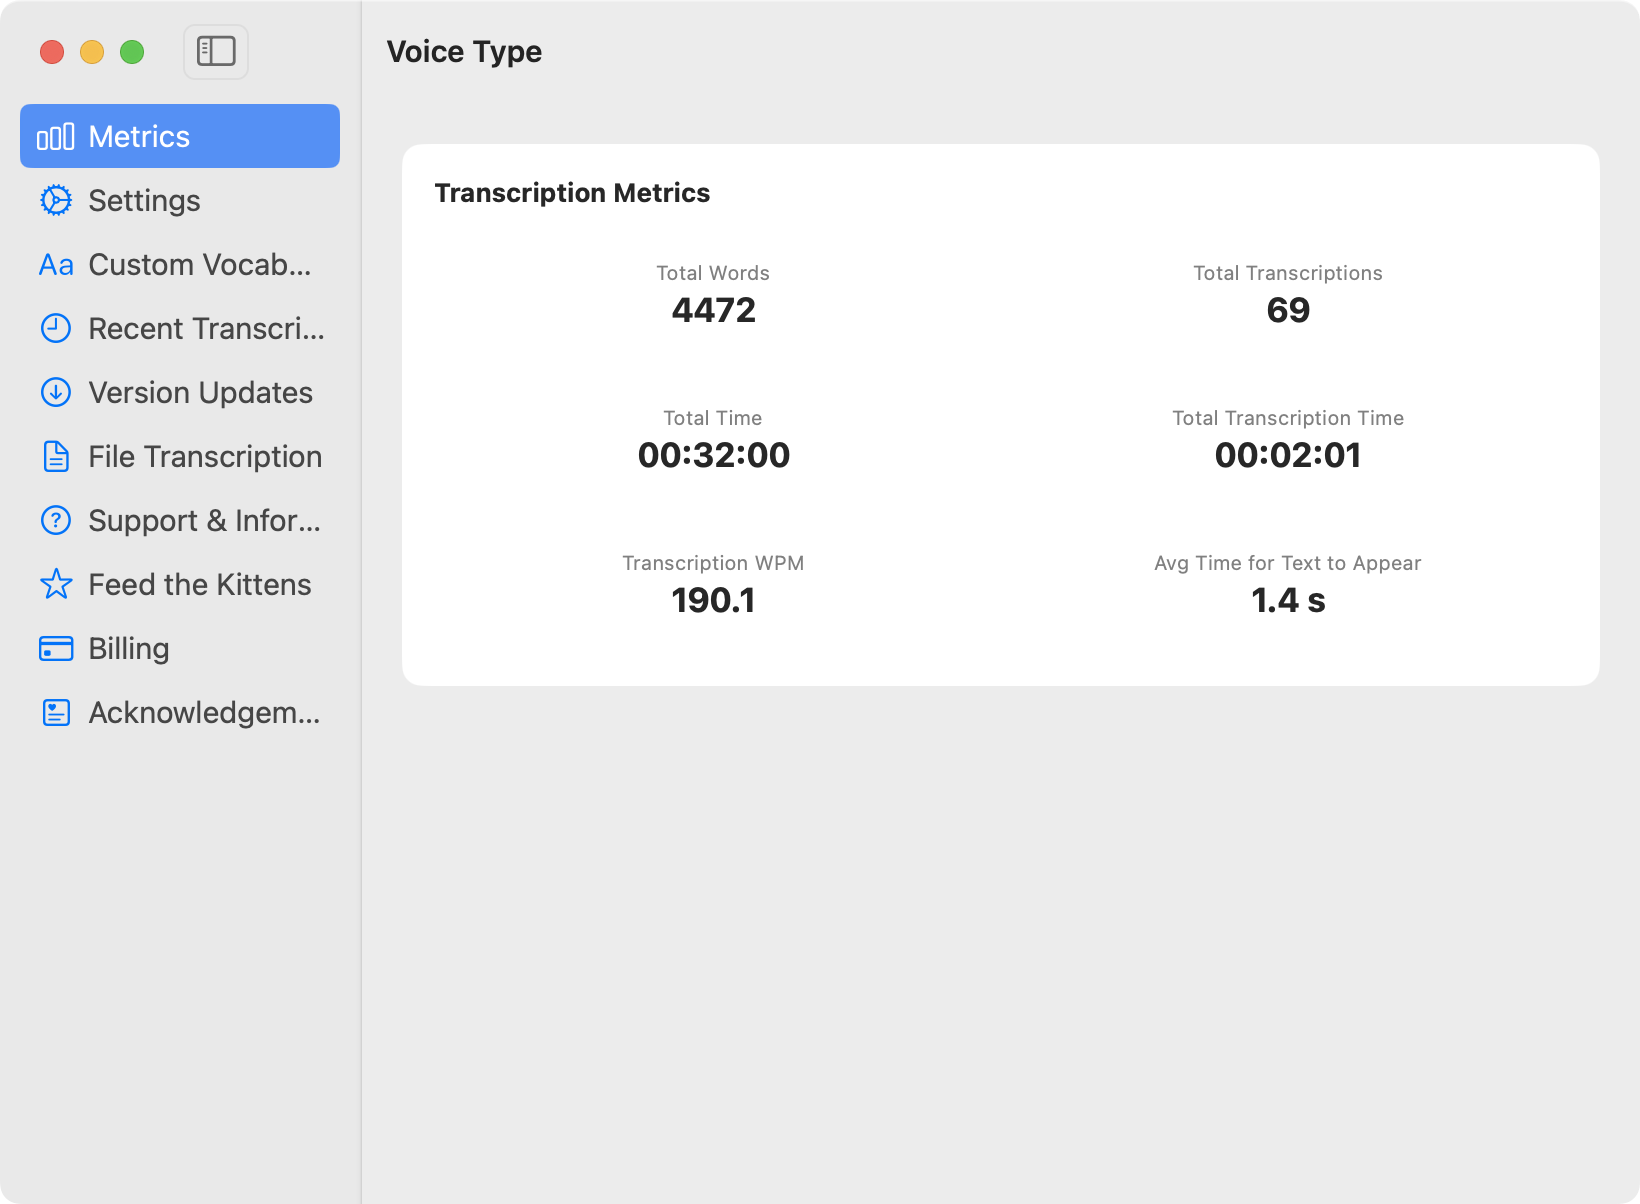
La demo de arriba es un modelo. La app también lleva sus propios contadores, así que la mitad local del modelo tiene un número real al lado. La sesión de abajo promedió 1,4 segundos desde que terminó el habla hasta que apareció el texto en pantalla a lo largo de 69 transcripciones, sin subida ni viaje de ida y vuelta en esa ruta.
Referencias
Voice Type mantiene la ruta del audio en local. Las reescrituras opcionales pueden seguir usando tu propio LLM, pero el paso de reconocimiento de voz no tiene que esperar a la red.
Prueba los 7 días de prueba gratuita