
السؤال المفيد ليس هل التعرّف السحابي على الكلام «سريع». بل أين يذهب الوقت بعد أن تتوقف عن الكلام. يستطيع المسار المحلي إزالة تأخير الرفع والذهاب والإياب مع الخادم. أما المسار السحابي فلا يستطيع.
تنقيح بمفتاحك الخاص
زمن الاستجابة 60ms · رفع 5 Mbps
الإملاء السحابي
رفع الصوت ← STT سحابي
Voice Type
STT محلي ← إعادة صياغة LLM
يبقى الصوت على جهاز ماك لديك. النص وحده يُرسل إلى LLM.
Voice Type أسرع بمقدار 11s (انتظار أقل بنسبة 80%)
تفاصيل الحساب
• الصوت السحابي: 128 kbps، وسرعة STT نحو 50 ضعف الزمن الحقيقي
• على الجهاز: نحو 1.2 ثانية للإنهاء على M1 Pro
• LLM: نحو 1000 رمز في الثانية على Cerebras
• الكلام: نحو 225 كلمة في الدقيقة (متحدث سريع)
كيف تقرأ العرض
- يشمل المسار السحابي مصافحة الشبكة، وزمن الرفع، وزمن التعرّف، والحمل الإضافي للخدمة.
- يُبقي المسار المحلي التعرّف على الكلام على الجهاز، ولا يضيف وقتًا إضافيًا إلا إذا طلبت إعادة صياغة النص عبر خدمة خارجية.
- الغاية ليست إنتاج رقم سحري واحد، بل إظهار الأجزاء التي تختفي من المسار حين لا يضطر الصوت إلى مغادرة الجهاز.
ما يفترضه النموذج
يعتمد العرض التفاعلي على افتراضات بسيطة وصريحة: زمن الذهاب والإياب في الشبكة، وعرض نطاق الرفع، وسرعة تقريبية للتفريغ السحابي، وخطوة إنهاء محلية لآخر جزء من الكلام. وهذا ما يجعله صادقًا. قد يختلف المزوّدون الفعليون، لكن بنية التأخير تبقى كما هي.
وهذا يطابق الطريقة المعتادة في توثيق أنظمة الكلام المتدفقة: يُقسَّم الصوت إلى أجزاء، ويُرسَل عبر بث مباشر، ويُعالَج تدريجيًا، ثم يُنهى بعد انتهاء الكلام. وتأخيرات الشبكة الأكبر وعمليات الرفع الأبطأ لا بد أن تُدفع كلفتها في مكان ما.
لماذا يهم هذا في الاستخدام الفعلي
- لملاحظة من سطر واحد على ألياف سريعة، قد يبدو التأخير السحابي مقبولًا.
- ومع دفعات الإملاء القصيرة المتكررة أثناء العمل المعتاد، تتراكم كل ثانية إضافية على شكل احتكاك.
- ومع شبكة Wi-Fi سيئة في فندق أو في القطار أو في حالات انعدام الاتصال، لا يعود الفرق في السرعة، بل في هل يعمل المسار أصلًا.
ماذا يقيس المسار المحلي عمليًا
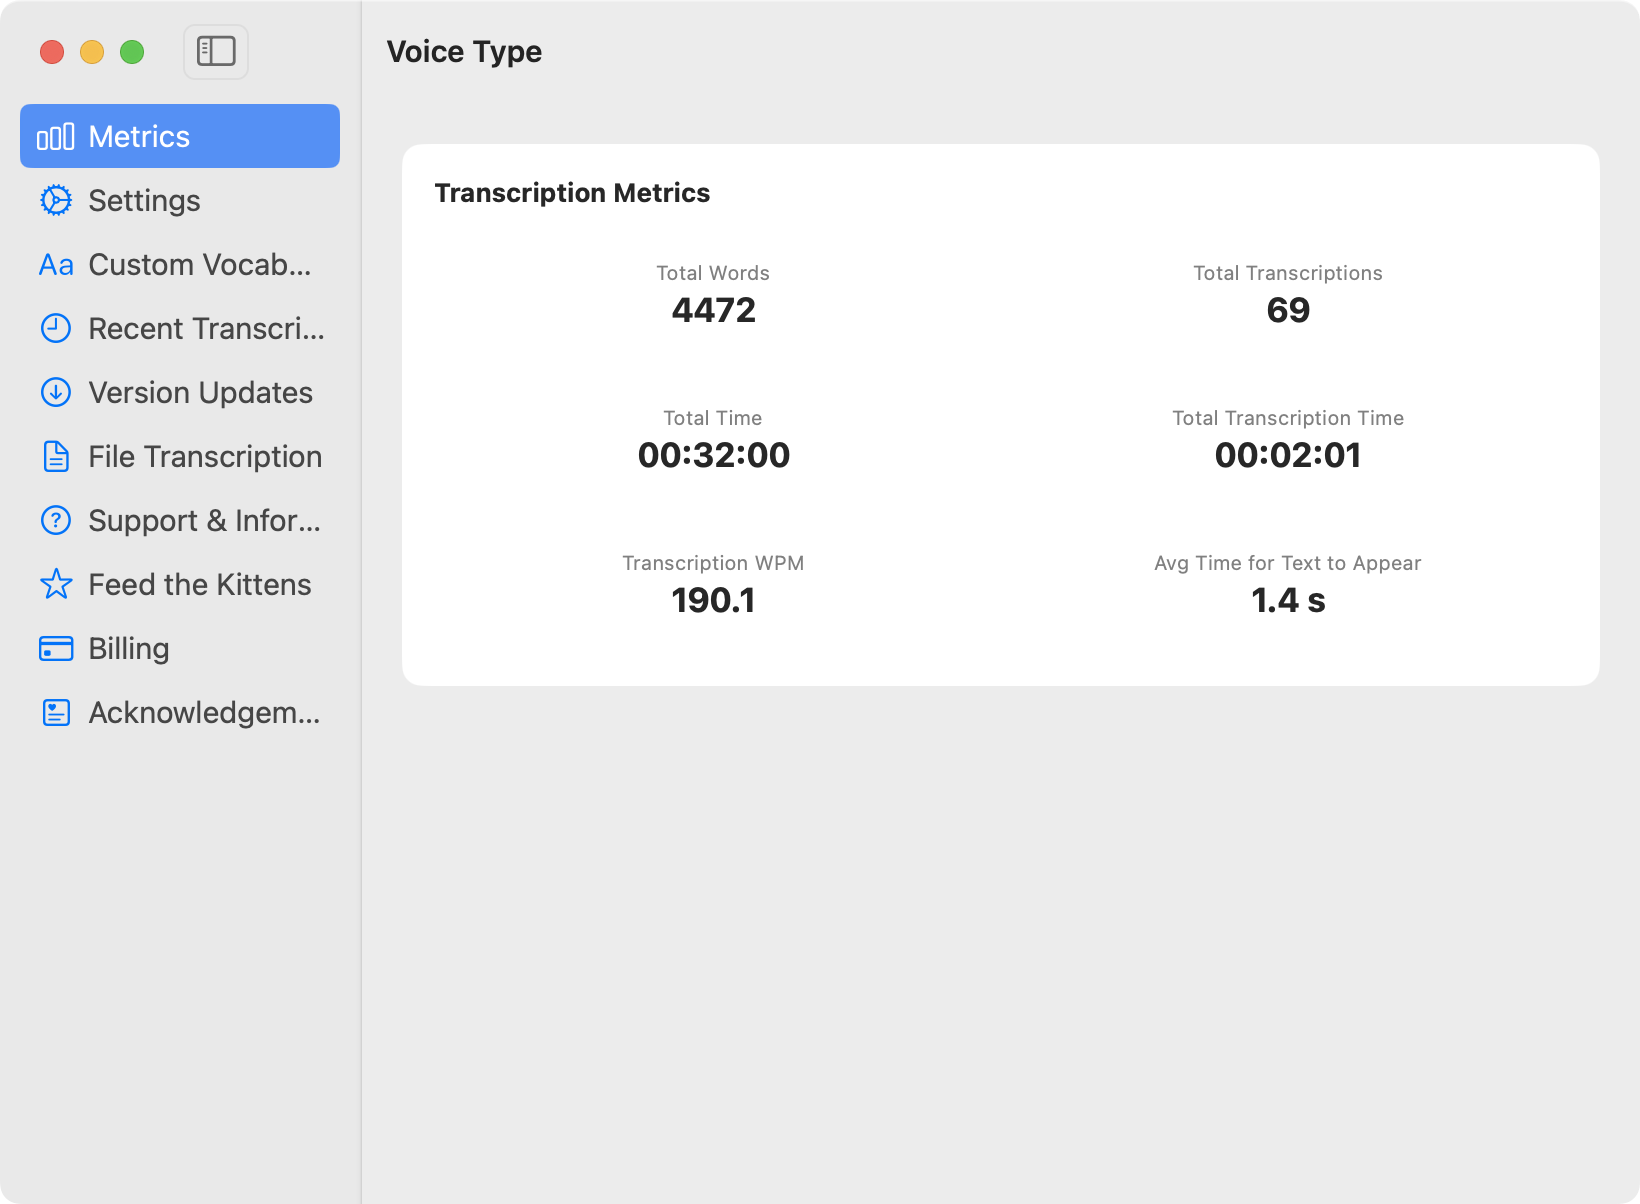
العرض أعلاه نموذج. كما يحتفظ التطبيق بعدّاداته الخاصة، فيجد النصف المحلي من النموذج رقمًا حقيقيًا بجانبه. بلغ متوسط الجلسة أدناه 1.4 ثانية من نهاية الكلام حتى ظهور النص على الشاشة عبر 69 عملية تفريغ، دون رفع ولا ذهاب وإياب في هذا المسار.
المراجع
يُبقي Voice Type مسار الصوت محليًا. ولا يزال بإمكان إعادة الصياغة الاختيارية استخدام نموذج LLM الخاص بك، لكن خطوة التعرّف على الكلام لا تحتاج إلى انتظار الشبكة.
جرّب النسخة التجريبية المجانية لمدة 7 أيام